在生活中,我們漸漸習慣由 AI 輔助完成各種工作,監視系統也不例外。
像是工廠利用 PPE 偵測,確認人員有沒有戴安全帽、穿反光背心;長照中心利用跌倒偵測,讓照護人員第一時間發現異常;大型表演藝術中心則利用人流分析,避免因人潮過多造成推擠。
這些 AI 的目的都是一樣,在事情發生前先發現異常,彌補人力有限、容易疲勞及視覺死角等問題。
看得到,卻無法理解?傳統 AI 缺少的是「情境判斷」
目前常見的 AI 影像辨識,大多是建立在大量資料訓練上。
以安全帽為例,人們透過大量不同角度、光線和顏色的安全帽影像訓練 AI,因此只要在模型學習過的範圍內,人員出現在鏡頭前,它就能快速判斷是否有依規定配戴。
傳統 AI 並不是不好,而是它的能力來自於訓練資料。它擅長辨識已經學習過的目標,像是安全帽、反光背心、人員跌倒或車輛等特定事件。只要在學習過的範圍內,通常都能提供穩定且準確的結果。
情境思考:
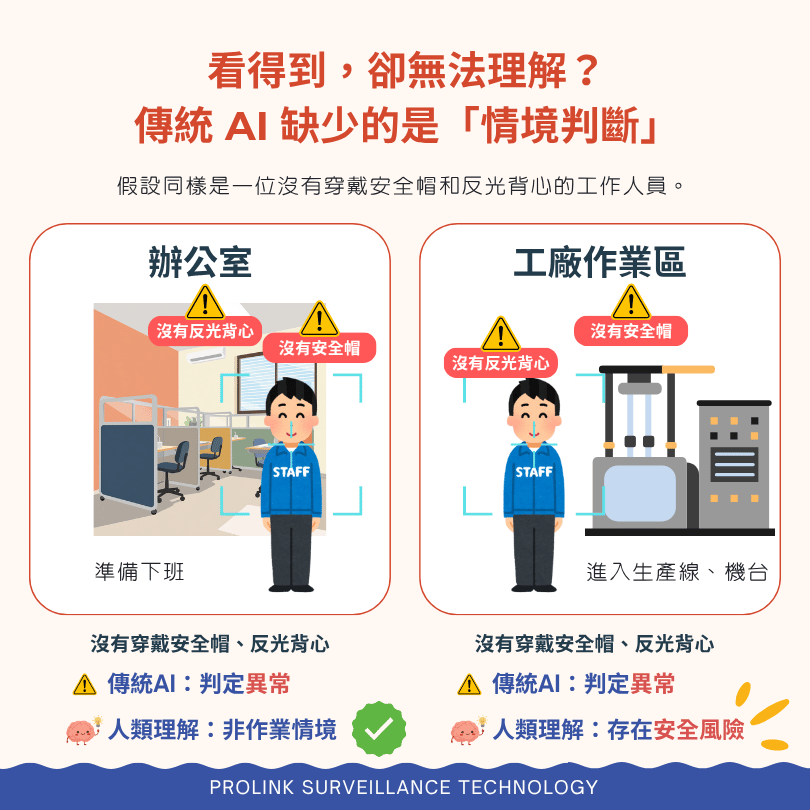
假設同樣是一位沒有穿戴安全帽和反光背心的工作人員。
- 站在辦公室,可能只是準備下班
- 站在工廠作業區,就代表存在安全風險。
人一眼就能理解兩者的差異,但傳統 AI 擅長的是「辨識目標」,而不是「理解場景」。它能辨識出「沒有安全帽」,但無法像人一樣判斷:「人在哪裡沒有穿戴,才真正存在安全風險。」這正是生成式 AI 開始導入智慧監控的關鍵原因。
生成式 AI 更適合處理沒有固定樣態的事件
當攝影機一樣負責「看」畫面,生成式 AI(Generative AI)則扮演「大腦」的角色,開始理解畫面裡發生了什麼事。
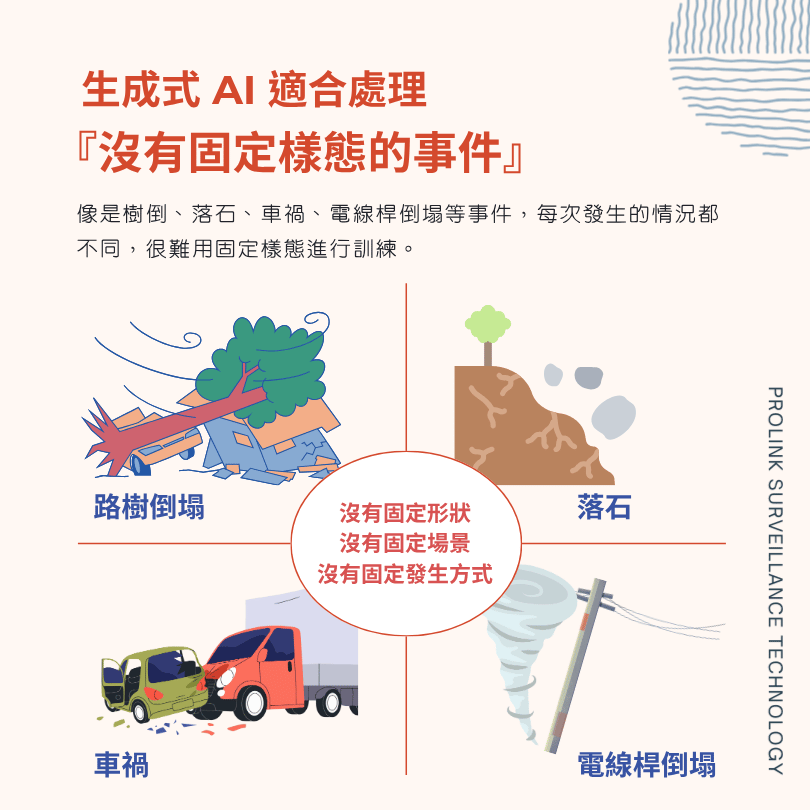
對於沒有固定樣態的事件,更能看出生成式 AI 的價值。像是天災、樹倒、落石、車禍或電線桿倒塌,每次發生的狀況都不同,很難利用固定模式進行訓練。
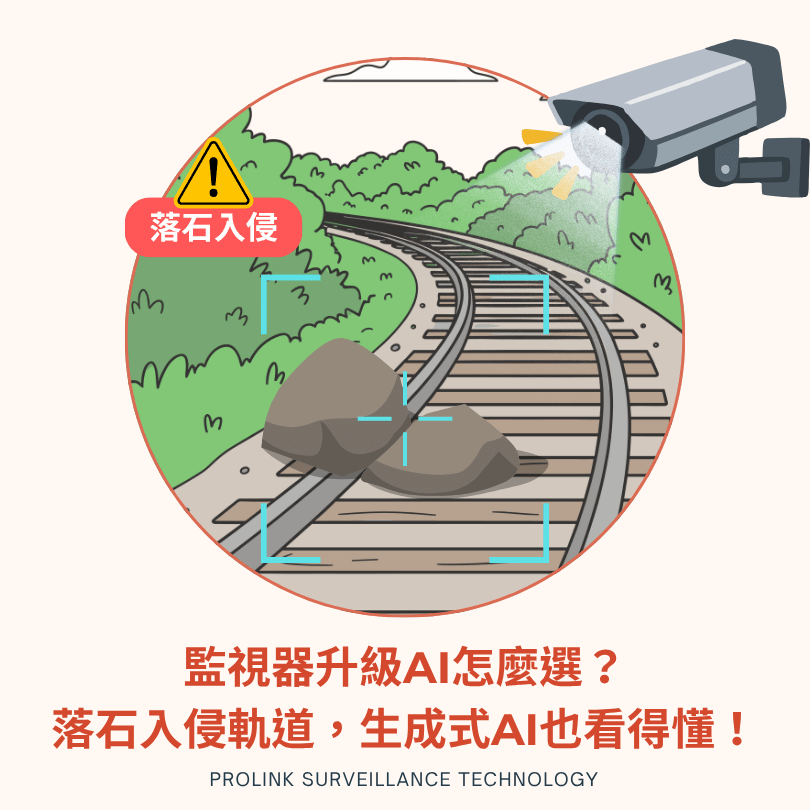
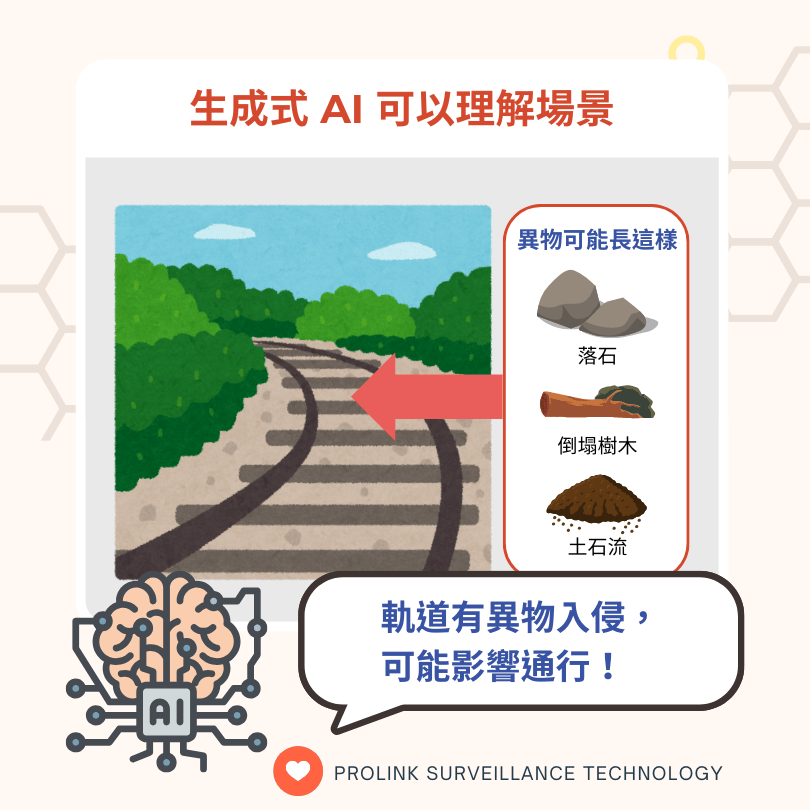
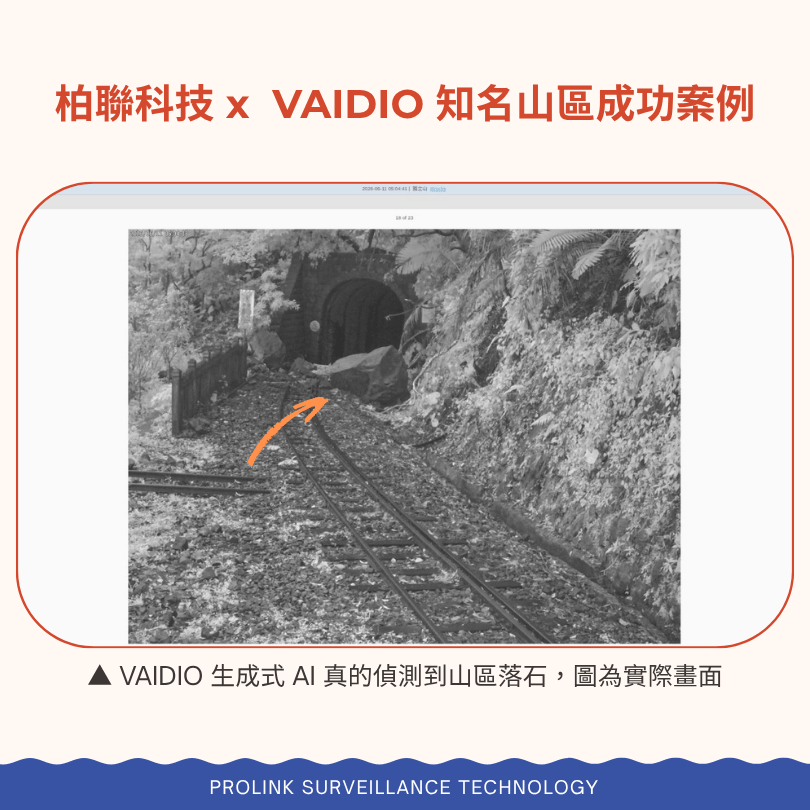
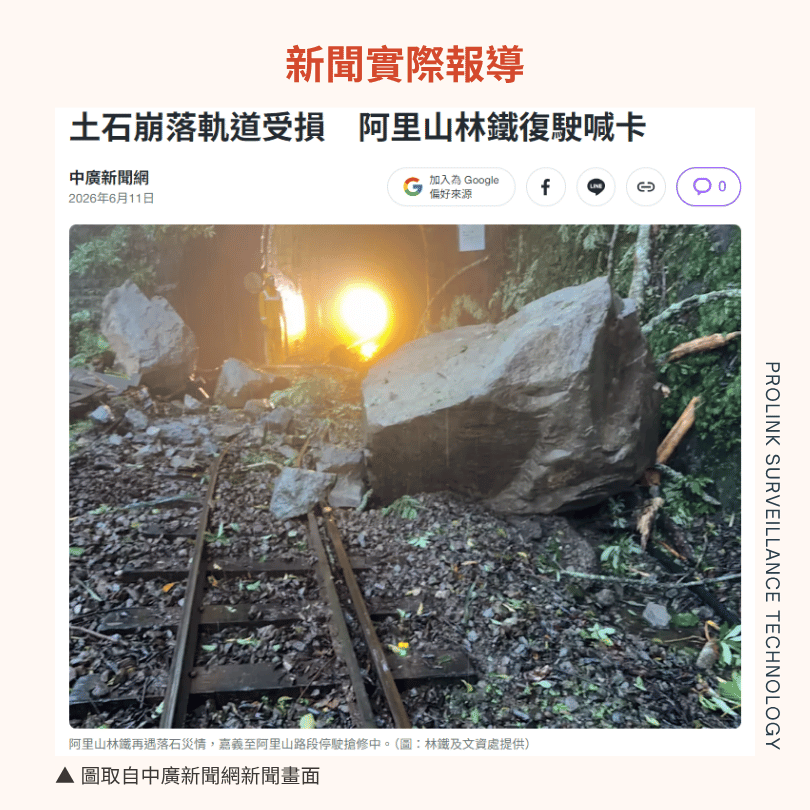
以柏聯科技的知名山區軌道異物入侵案場為例,近期受到豪雨影響,軌道旁經常出現落石、倒塌樹木及泥沙堆積。
這些異物每次出現的樣貌都不同,可能是一顆大石頭,也可能是一堆碎石;有時是倒下的樹枝,有時是土石流覆蓋路面。
這些都會影響通行,但很難事先收集所有情境來訓練傳統的 AI。所以像這類需要理解現場情況,再判斷是否有危險的場景,就很適合導入生成式 AI。不需要再花大量的人力24小時盯守,假日也不必另外派人管控。
在知名山區案場,便採用鐵雲科技的生成式 AI(Generative AI)進行軌道異物偵測,而背後所使用的,正是近年受到關注的 LLaVA 技術。
LLaVA 是什麼?
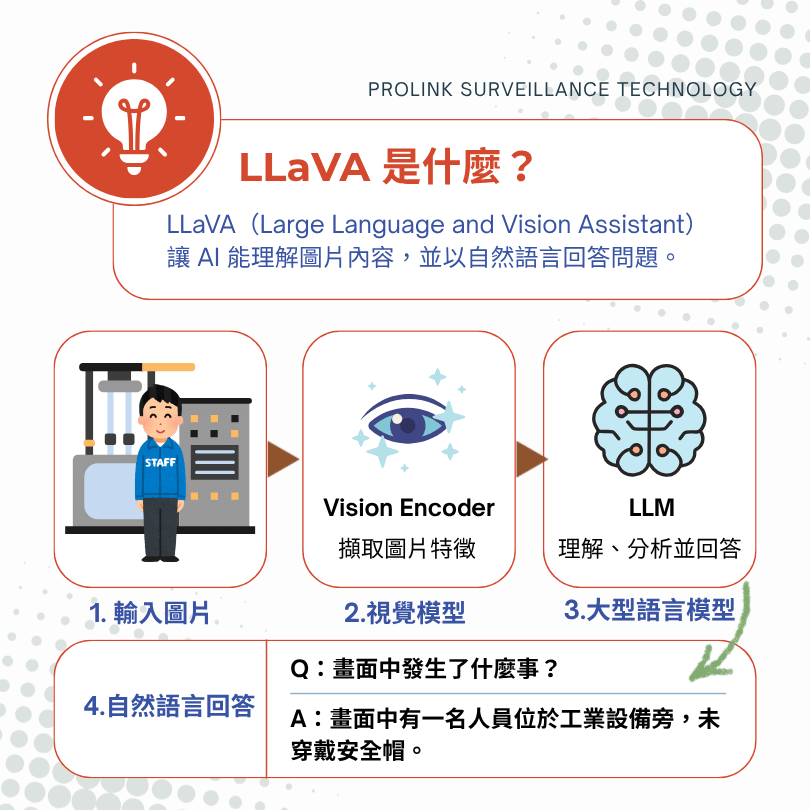
LLaVA(Large Language and Vision Assistant)開發團隊最初希望讓大型語言模型不只理解文字,也能理解圖片,並回答與圖片相關的問題。
當時GPT-4 已展現出強大的多模態能力,也就是能同時理解文字與圖片,但模型細節並未公開。因此,研究團隊希望利用開源模型實現類似的視覺對話能力。
為了達成這個目標,LLaVA 結合了視覺模型(Vision Encoder)與大型語言模型(LLM),讓 AI 不只是辨識畫面中的物件,更能理解圖片內容,並以自然語言回答問題。
後來,這項技術逐漸延伸到智慧監控、文件解析、工廠巡檢及企業多模態 AI 助理等領域。
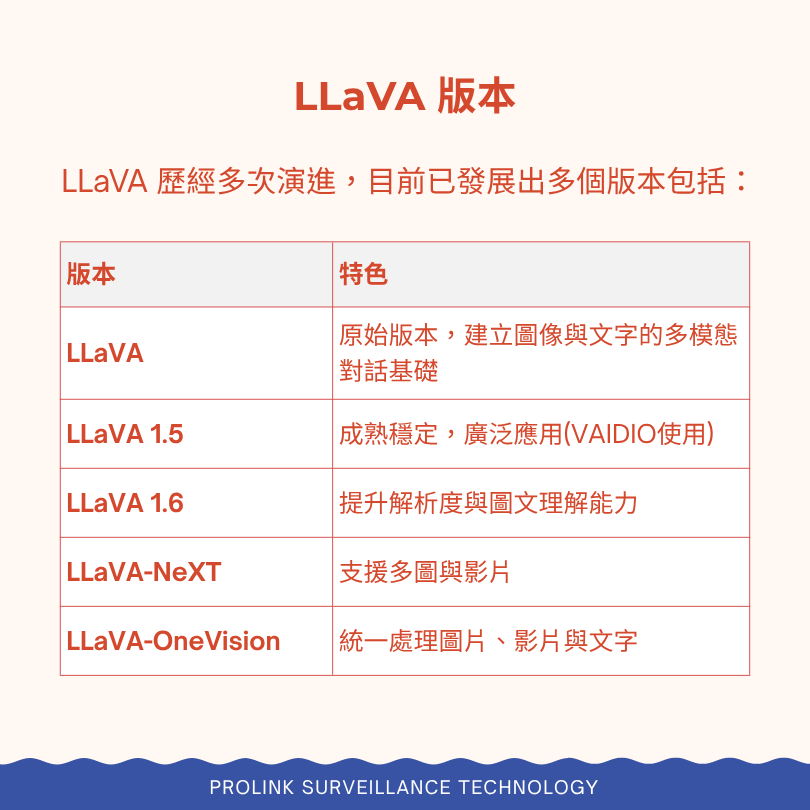
LLaVA 歷經多次演進,目前已發展出多個版本包括:
LLaVA 在智慧監控的3大優勢
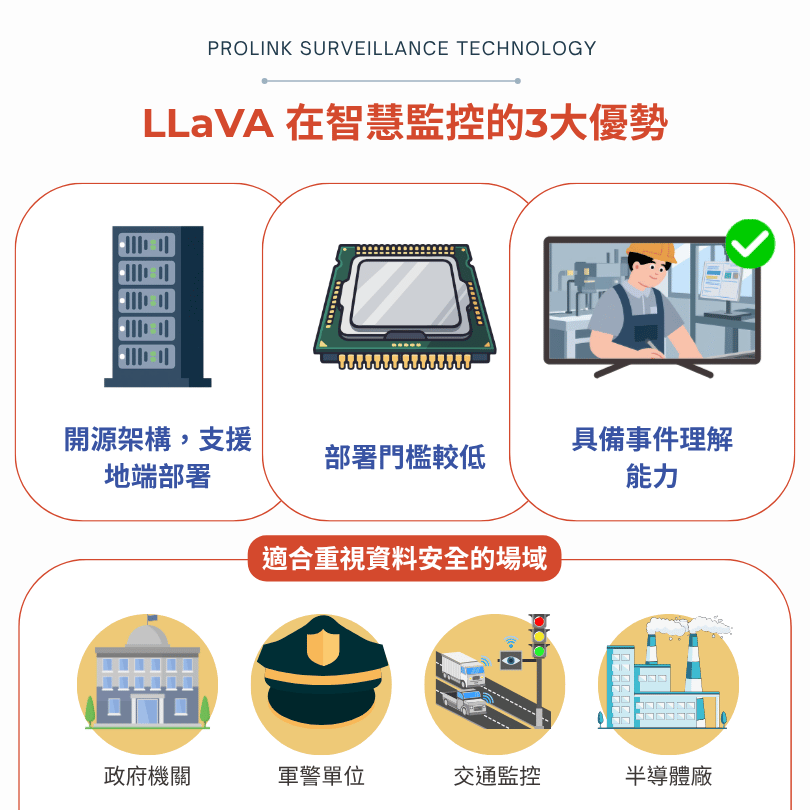
1. 開源架構,支援地端部署
相較於商業模型GPT-4o、Gemini、Claude必須連接雲端服務,LLaVA 採用開源架構,可自行下載部署,不必將資料傳送至外部雲端。對於政府機關、軍警單位、交通監控、半導體廠等重視資料安全的場域,更適合導入地端 AI 系統。
2. 部署門檻較低
LLaVA 1.5 提供 7B、13B 等不同模型規模,其中 7B 模型即可提供不錯的影像理解能力,在兼顧運算效率的同時,也降低企業導入生成式 AI 的門檻。
3. 具備事件理解能力
LLaVA 不只看見畫面中的人物、車輛或物件,更能理解事件內容,將影像轉換成自然語言描述。搭配 YOLO 等即時偵測模型後,可應用於安全帽辨識、人員跌倒、火焰煙霧、人數統計及異常事件分析,形成完整的 AI 視覺分析系統。
VAIDIO 生成式 AI 系統架構
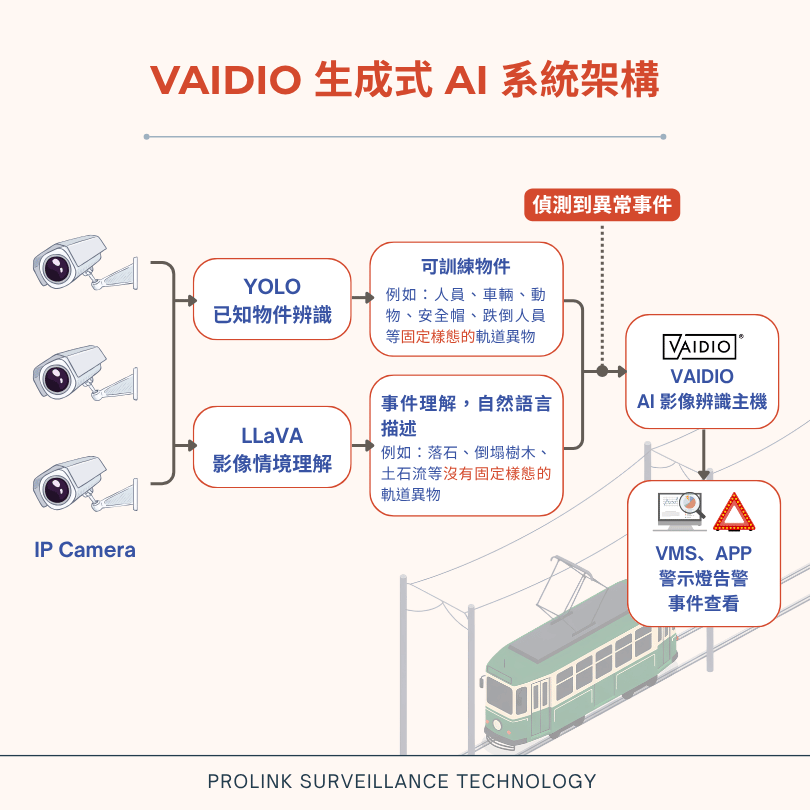
在 VAIDIO 的生成式 AI 架構中,YOLO的即時偵測模型主要負責辨識已經訓練過的目標,例如人員、車輛、動物、安全帽或跌倒事件。這類事件具有明確特徵,能快速完成辨識與告警。
但像落石、倒塌樹木、土石流的泥沙堆積等情況,每次出現的樣貌都不同,很難事先定義成固定類別。這時便由 LLaVA 負責理解畫面內容,將看到的情況轉換成自然語言描述,幫助判斷是否影響通行或存在風險。
最後再由 VAIDIO 整合兩種 AI 的分析結果,透過 VMS、APP 或警示設備通知管理人員查看事件。
柏聯科技 x VAIDIO 知名山區成功案例
鐵雲科技 VAIDIO 採用成熟穩定的 LLaVA 1.5 架構,並使用 70 億參數(7B)模型,讓 AI 影像辨識從純「辨識」進入「理解」階段,能夠描述畫面內容,並進一步理解事件背後的情境,找出可疑物件。
Schedule An Appointment
需要產品建議或技術諮詢嗎?
歡迎與我們聯繫,我們將提供專業建議與產品資訊